
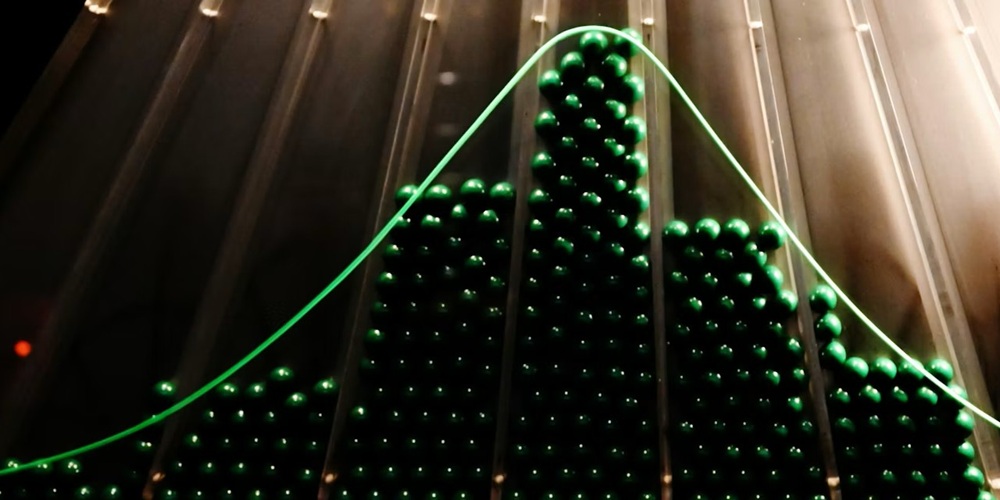
Una frontera invisible llamada «valor p» define qué fármacos se aprueban, qué carreras académicas prosperan y qué descubrimientos llegan a las tapas de los diarios. Sin embargo, este número nació hace un siglo como una simple sugerencia al pasar y hoy alimenta una crisis metodológica que divide a la comunidad científica.
Si alguna vez te pusiste a ojear un paper o una noticia sobre un nuevo tratamiento médico, seguro te cruzaste con una letra minúscula que suele definirlo todo: el valor p (o p-value). Este diminuto decimal opera en los laboratorios como un juez supremo. Si da por debajo de cierta línea mágica, el experimento se corona como un éxito rotundo; si queda apenas una milésima por encima, el trabajo entero puede terminar archivado en un cajón.
El problema es que, detrás de ese veredicto inapelable, se esconde uno de los conceptos más incomprendidos de la historia científica. Y no hablamos solo del público general: una porción alarmante de investigadores y médicos en ejercicio también lo interpreta de forma equivocada.
Desarmando el Mito del Valor P
Qué mide realmente y por qué el umbral de 0,05 desata tantas controversias
Lo que NO Significa
- No indica la probabilidad de que tu hipótesis sea verdadera.
- No mide si el hallazgo es importante en la vida real.
- Un resultado «no significativo» no prueba que no haya diferencias.
Lo que SÍ Mide
Es la probabilidad de obtener datos tan extremos como los observados asumiendo que en la realidad no existe ningún efecto o diferencia (hipótesis nula).
La Regla de Oro: Ningún número aislado puede reemplazar el juicio crítico, el diseño experimental riguroso y la estimación del tamaño del efecto.
La ruleta de las muestras y la ilusión de la certeza
Para entender el embrollo sin caer en fórmulas complejas, imaginemos una situación cotidiana. Querés averiguar si los adultos de un país son, en promedio, más altos que los de otro vecino. Como resulta imposible medir a millones de personas una por una, tomás una muestra al azar de 50 personas de cada nación.
Al calcular los promedios, el primer grupo mide 1,80 metros y el segundo 1,77 metros. Esos tres centímetros de diferencia parecen decir algo, pero en realidad no prueban nada por sí solos. Cualquier par de muestras va a diferir ligeramente por pura casualidad, simplemente por quiénes caminaban por la calle cuando hiciste la encuesta.
¿Esa brecha refleja una diferencia biológica real en toda la población o fue solo un golpe de suerte en el sorteo de los participantes? Para responderlo, se aplica una prueba estadística que arroja un valor p (donde la «p» refiere a probabilidad). Supongamos que el cálculo da p = 0,06.
Acá es donde se produce el gran cortocircuito mental. Ese número significa exactamente lo siguiente: si en la realidad no hubiera ninguna diferencia entre ambos países, ver una brecha de tres centímetros o más ocurriría apenas el 6% de las veces por puro azar de muestreo.
Fijate con atención en lo que no significa: no quiere decir que haya un 6% de probabilidades de que el resultado sea falso, ni que exista un 94% de certeza de que los países difieren. El valor p describe qué tan improbable sería observar tus datos si en el mundo real no estuviera pasando absolutamente nada. Cambiar el orden de esa frase parece un juego de palabras, pero transforma por completo el rigor de una conclusión.
El capricho del 0,05 y el drama de los decimales
Por convención internacional, la frontera que separa el éxito del fracaso se fijó en 0,05. Si el cálculo da menos que eso, el resultado se rotula como «estadísticamente significativo». En nuestro ejemplo de las alturas, con un 0,06, el estudio se publicaría afirmando que no hubo diferencias significativas.
¿De dónde salió ese número sagrado? De ningún teorema matemático divino. En la década de 1920, el influyente estadístico británico Ronald Fisher lo deslizó en un manual práctico como una regla orientativa, una sugerencia cómoda para el trabajo diario. Con el correr de las décadas, la comodidad se transformó en un dogma rígido.
Tener un umbral de 0,05 fija una tasa de falsas alarmas que la ciencia acordó tolerar: si no hay ningún efecto real, uno de cada veinte estudios dará «significativo» por pura chiripa. Lo absurdo es la frontera tajante que genera en la vida real: si tu experimento da p = 0,049, descorchás champán y anunciás un descubrimiento histórico; si da p = 0,051, la comunidad actúa como si nada hubiera ocurrido.
Importancia estadística versus importancia real
La confusión se vuelve más peligrosa cuando se mezcla la estadística con el sentido común. En el lenguaje de todos los días, «significativo» es sinónimo de importante o trascendente; en los laboratorios, solo significa que el dato logró cruzar una valla matemática.
Pensalo con este ejemplo: supongamos que un ensayo clínico con 40.000 personas demuestra que un nuevo suplemento aumenta el coeficiente intelectual en apenas medio punto, con un aplastante p < 0,001. El resultado es estadísticamente indiscutible, pero medio punto de CI es una diferencia insignificante para la vida de cualquier ser humano.
En la vereda opuesta, un ensayo más modesto con pocos pacientes podría detectar una mejora impactante de cinco puntos de CI pero obtener un p = 0,06. El paper dirá que no es significativo debido al tamaño de la muestra o al «ruido» de los datos (la variación natural entre individuos), a pesar de que el efecto encontrado, de confirmarse, sería muchísimo más valioso. Por eso, ningún valor p debería leerse de forma aislada sin mirar el tamaño del efecto (effect size), que responde a la pregunta que de verdad importa: ¿cuán grande y útil es la diferencia?
La tentación del p-hacking y el llamado a reformar la ciencia
La obsesión por perforar el piso del 0,05 abrió la puerta a una práctica tan extendida como preocupante: el p-hacking (la manipulación o «cocina» de datos).
Si un equipo prueba un fármaco en 50 voluntarios y obtiene un frustrante p = 0,08, la tentación de sumar diez pacientes más para ver si baja a 0,06 y luego otros diez hasta que toque el ansiado 0,049 es gigantesca. Frenar el experimento justo en el instante en que se cruza la línea altera las probabilidades y fabrica hallazgos que después jamás logran replicarse en otros laboratorios.
Frente a este escenario, la rebelión metodológica ya está en marcha. En 2019, más de 800 científicos de primer nivel firmaron una carta abierta reclamando retirar formalmente el concepto de «significancia estadística», y algunas revistas científicas internacionales llegaron a prohibir el uso del valor p en sus páginas para forzar a los autores a publicar intervalos de confianza y magnitudes de efecto reales.
Tirar el valor p a la basura por completo quizás sea una medida extrema, porque sigue siendo una herramienta matemática útil para descartar el ruido de fondo. El desafío hacia adelante no pasa por prohibir un decimal, sino por dejar de tratarlo como un oráculo incuestionable de la verdad.
Referencia:
Hewitt, K. (2026, 28 de julio). What is a p-value? An expert explains the most misunderstood number in science. The Conversation.
https://doi.org/10.64628/AA.acnkmv5vh
Por Daniel Ventuñuk
En base al artículo de Kyle Hewitt publicado en The Conversation

